采访录音如何整理?用Whisper转写、定位与人工校对
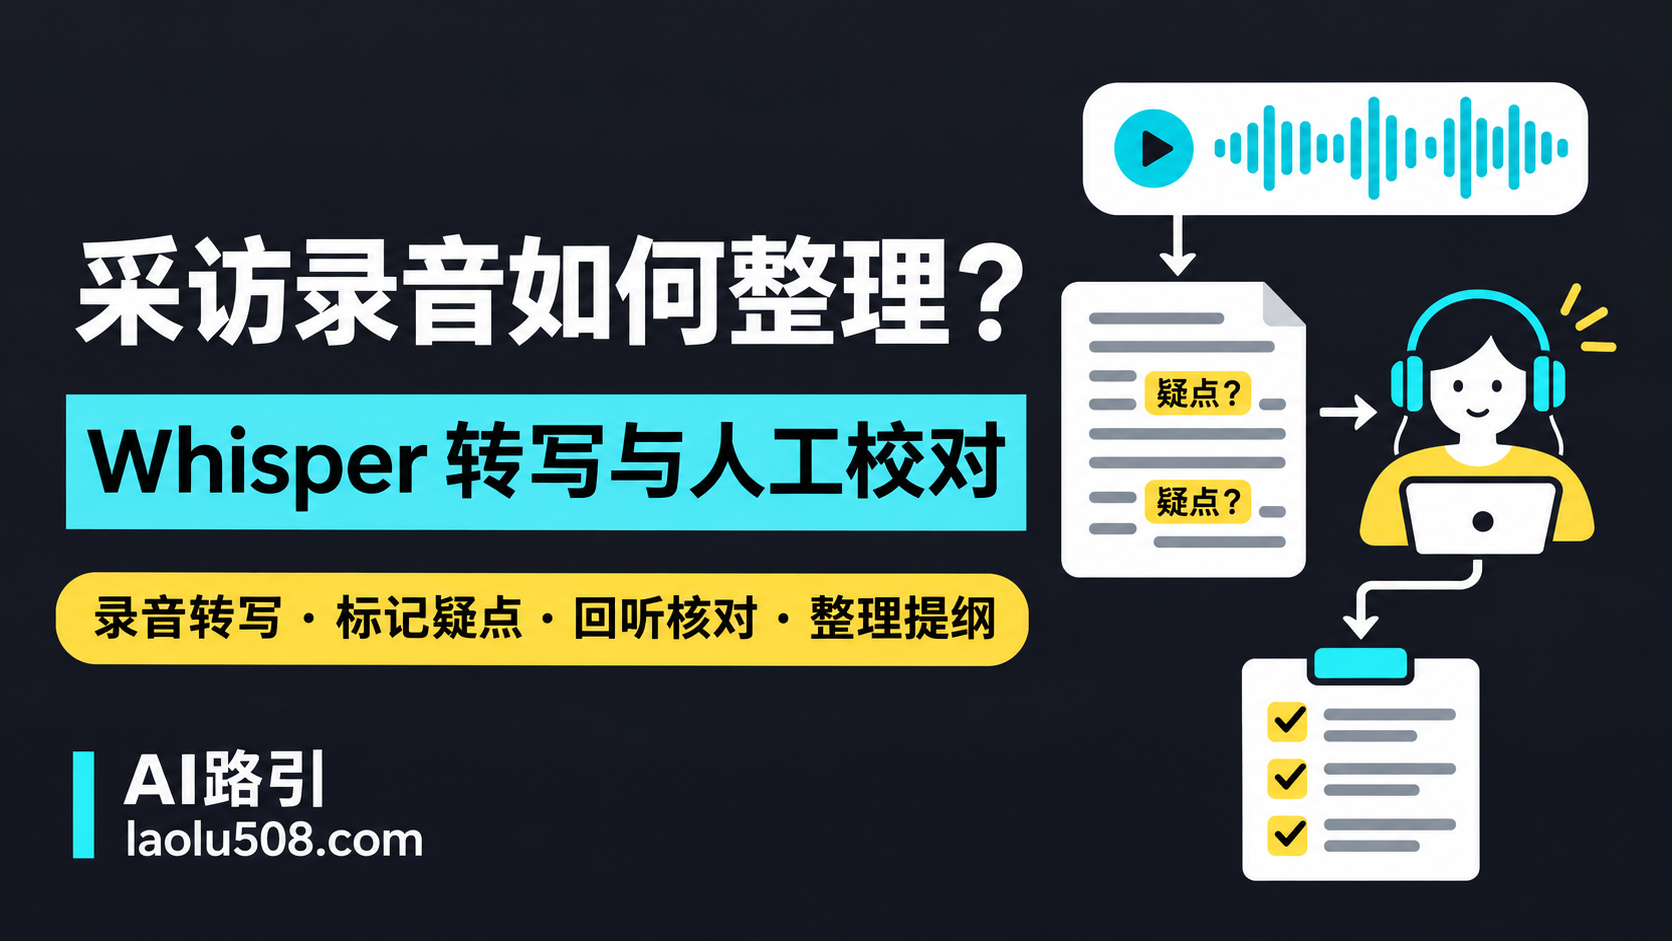
采访录音转成文字后,最费时间的往往不是“听写”,而是核对人名、数字、观点归属和可公开范围。下面以本地运行 OpenAI Whisper 为例,把采访录音整理成带时间位置的待审核稿,再由编辑回听确认。流程适合内容团队处理已获授权的采访素材,不把自动转写结果当作可直接发布的原稿。
先确定使用范围与交付物
试点只选一段已取得录制和内部处理授权的短音频,先复制一份工作副本,原始文件只读保存。交付物包含:原始录音编号、分段转写、时间位置、待核对词、编辑摘要和最终审核人。涉及未公开商业信息、个人联系方式或其他敏感内容时,先按团队规则脱敏,不上传到未经批准的服务。
Whisper 是语音识别工具,不会替编辑判断事实是否准确、某句话能否公开,也不能保证区分所有说话人。原始录音始终是核对依据,转写稿只是检索和编辑的中间材料。
步骤 1:整理音频与专有词表
给音频使用不含受访者姓名的内部编号,例如 INT-2026-011.wav。记录录制日期、语言、时长、授权范围和负责人;把姓名、品牌、产品型号、地名等容易识别错误的词整理成专有词表。音量过小、多人同时说话或背景噪声很重时,先标记风险,不要假定换一个模型就能自动修复。
OpenAI Whisper 官方仓库说明其运行依赖 FFmpeg,并提供多种模型大小;速度与显存需求不同。部署前先核对当前仓库说明和设备条件,测试阶段只处理副本。
步骤 2:生成带时间位置的初稿
在已安装 Whisper 与 FFmpeg 的内部环境中运行转写。以下命令仅展示结构,请根据实际文件路径、语言和设备调整:
whisper INT-2026-011.wav
  --model turbo
  --language Chinese
  --task transcribe
  --output_format all
  --word_timestamps True
官方命令行支持 TXT、VTT、SRT、TSV、JSON 等输出。编辑流程建议保留 JSON 或 TSV 作为核对依据,同时生成 VTT/SRT 方便定位。若设备只能使用 CPU,应先用一小段样本测耗时;不要用预计速度代替实际测试记录。
步骤 3:标记需要回听的内容
把转写结果导入表格或编辑系统,至少保留 start_time、end_time、speaker_note、transcript、review_flag 和 source_file。先用规则标记数字、日期、专有名词、否定表达和听不清的位置,再让 AI 根据已确认文本生成待核对提纲,不能让它补写录音里没有的内容。
| 检查项 | 编辑动作 |
|---|---|
| 人名、机构名、产品名 | 对照专有词表并回听对应时间段 |
| 金额、比例、日期 | 逐项回听,不凭上下文猜测 |
| 多人交叉发言 | 人工标注说话人;无法确认时写“待确认” |
| 敏感或未公开内容 | 按授权范围处理,不进入公开稿 |
步骤 4:从核对稿生成采访提纲
只有在关键字段完成回听后,才把核对稿交给 AI 整理为“主题、核心观点、可引用原句位置、待追问事项”。提示词应要求每条观点附带时间位置,并明确:没有依据时返回“原文未提及”。编辑再对照录音确认引语是否完整,避免把不同段落拼成受访者未表达过的结论。
建议保留三层文件:原始录音、机器转写初稿、人工核对稿。任何删改只发生在副本中,并记录修改人和日期。
步骤 5:用四类样本验收
- 普通单人讲话:检查时间位置和主要句子是否可定位。
- 包含专有名词与数字:检查是否全部进入回听清单。
- 多人交叉或有噪声:检查系统是否避免擅自确认说话人。
- 一段空白或含糊内容:检查是否保留“不确定”,而不是补全句子。
验收不是追求“零错误率”,而是确认错误能被发现、定位并由编辑修正。上线前记录使用的模型、设备、处理时长、异常样本与人工复核时间,后续才能判断这套流程是否真的适合团队。
常见问题与边界
自动转写可能在口音、噪声、专有名词和多人对话中出错。公开引用还涉及授权、隐私和语境完整性,不能因为生成了文字稿就默认可以发布。对外内容应由编辑或项目负责人确认,必要时请受访者核对关键引语。
下一步
主要入口:进入 AI路引自动化流程栏目,继续设计带人工复核的内容整理流程。
相关文章:自媒体团队如何用 AI Agent 制作短视频,可把已经核对的采访提纲接入脚本与分镜环节。
参考来源:OpenAI Whisper 官方仓库及其使用说明。本文是内部流程实施蓝图,不代表任何具体环境已经达到生产标准;配图为 AI 生成的主题封面。