数字馆藏资料难检索?用AI整理题名、年代与来源字段
扫描资料的题名、年代和来源字段不统一时,检索效果会下降。本文设计元数据候选生成流程。
适用范围与准备材料
先用自制或脱敏样本试验,明确资料权限、最终审核人、更新时间和停止使用条件。原始资料保持只读,AI输出只作为待确认草稿。
详细实施步骤
步骤 1
定义字段规范和受控词表。执行时记录输入来源、负责人、时间和异常处理。
步骤 2
读取扫描件及已有目录信息。执行时记录输入来源、负责人、时间和异常处理。
步骤 3
生成候选题名、年代和主题词。执行时记录输入来源、负责人、时间和异常处理。
步骤 4
编目人员对照原件核验。执行时记录输入来源、负责人、时间和异常处理。
步骤 5
确认后导入并记录版本。执行时记录输入来源、负责人、时间和异常处理。
结果验收
- 不虚构作者或年代
- 不自动认定版权状态
- 来源位置可追溯
- 编目结果人工确认
同时测试正常、缺字段、冲突、重复和无答案情况,并记录人工修改量和回退方式。
常见问题与边界
Skill不能判断版权归属、文物价值或史实真伪。
下一步
主要入口:进入对应栏目查看同类实施方法。
相关文章:阅读相关指南,补充前置准备或人工复核步骤。
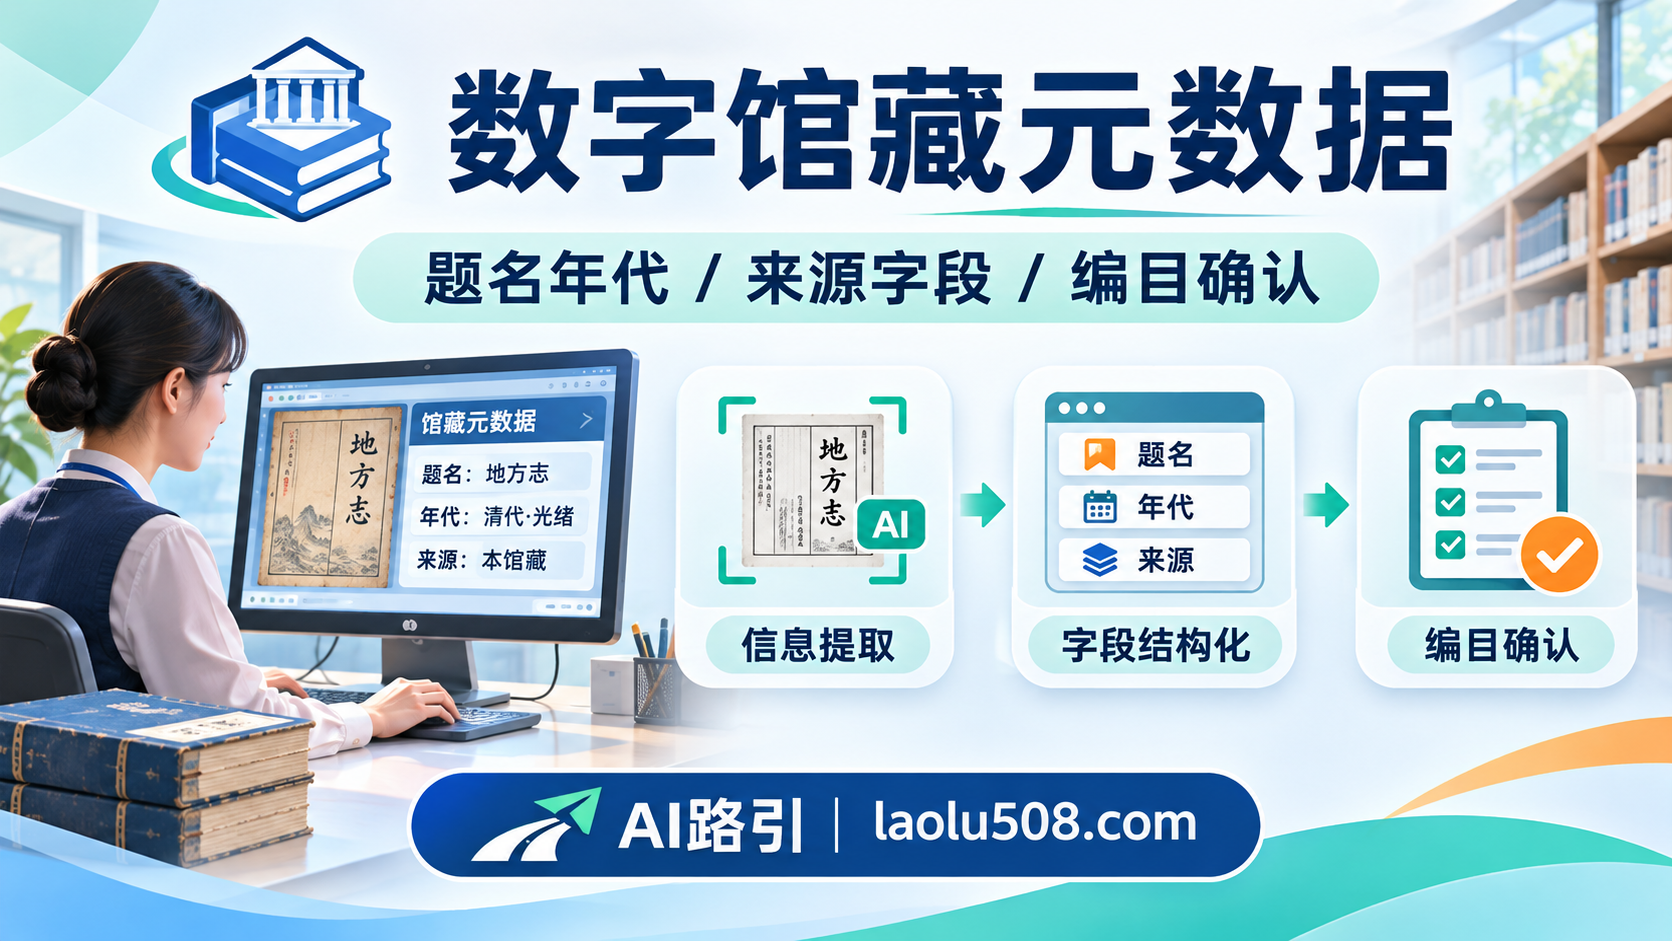
参考来源:OpenAI Structured Outputs 官方指南。本文为实施蓝图,不代表具体生产环境已验证;配图为AI生成主题封面。
特别提醒:在AI路引-AI工具 购买项目后,若下载地址不可见,请CTRL+F5刷新网页。会员免费下载本站所有资源。客服微信:laolu508